먼저 어떤 질문에 답할 숫자인지 정합니다
작업 시간, 배송 소요 시간이나 소규모 설문 결과를 정리할 때 평균 하나만 적으면 자료가 고르게 모여 있는지 알기 어렵습니다. 평균은 모든 값을 합해 개수로 나눈 값이고, 중앙값은 정렬했을 때 가운데 놓이는 값입니다. ‘한 건당 총량은 얼마인가’와 ‘중간에 있는 기록은 얼마인가’는 서로 다른 질문입니다.
이 글에서는 가상의 작업 시간 다섯 개로 차이를 비교합니다. 실제 이용자 기록이나 조사 결과가 아니며, 결과만 보고 모집단 전체의 특성을 단정하는 통계 추론은 다루지 않습니다.
한 값이 달라지면 평균과 중앙값은 어떻게 변할까
| 목록 | 합계 | 평균 | 중앙값 |
|---|---|---|---|
| 16, 18, 20, 22, 24 | 100 | 20 | 20 |
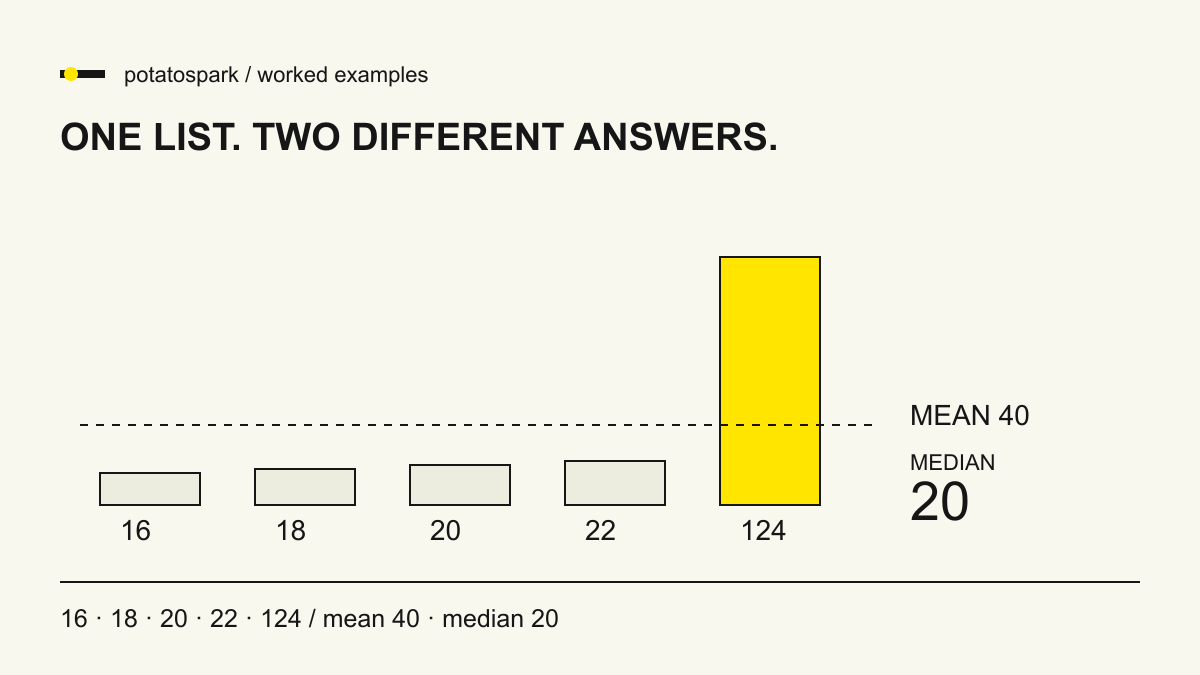
| 16, 18, 20, 22, 124 | 200 | 40 | 20 |
마지막 기록이 24분에서 124분으로 늘면 합계가 100분 증가합니다. 평균은 그 증가량을 5개에 나누어 20분 높아지지만, 정렬된 세 번째 값은 여전히 20분입니다. 평균 40은 틀린 계산이 아니고, 중앙값 20이 긴 작업을 없애 주는 것도 아닙니다.
튀는 값은 자동으로 지울 대상이 아닙니다. 124가 오타인지, 장애가 있었던 실제 기록인지 먼저 확인해야 합니다. 실제 발생한 긴 작업을 임의로 빼면 총 작업량을 작게 보고할 수 있습니다. 제외가 정당하다면 제외 사유와 제외 전·후 결과를 함께 남기세요.
값이 16, 18, 20, 22처럼 네 개이면 가운데 두 값 18과 20의 평균인 19가 중앙값입니다. 중앙값이 반드시 원래 목록에 있는 숫자인 것은 아닙니다.
평균의 평균은 그룹 크기를 놓칠 수 있습니다
A팀은 2건을 처리했고 평균 100분, B팀은 8건을 처리했고 평균 10분이라고 가정해 봅니다. (100 + 10) ÷ 2 = 55분은 ‘두 팀의 평균을 같은 비중으로 평균한 값’입니다. 전체 10건의 건당 평균과는 다릅니다.
두 팀을 똑같은 단위로 비교하려는 질문이라면 55라는 수치에도 별도의 의미가 있을 수 있습니다. 하지만 전체 건당 시간을 말하려면 건수로 가중해야 합니다. 월별 방문 수나 반별 시험 점수도 그룹 크기가 다르면 같은 주의가 필요합니다. 학점 수가 다른 과목은 학점 가중평균 가이드의 방식으로 계산합니다.
같은 평균이라도 퍼짐은 다릅니다
10, 10, 10의 평균은 10이고 0, 10, 20의 평균도 10입니다. 하지만 첫 목록은 모두 같고 둘째 목록은 20만큼 벌어져 있습니다. 최소·최대, 범위와 표준편차를 함께 보면 평균 하나가 감춘 차이를 확인할 수 있습니다.
이 사이트는 입력 목록 전체를 하나의 모집단으로 봅니다. 평균과의 차이를 각각 제곱해 합한 뒤 개수 N으로 나눈 분산에서 제곱근을 구합니다. 따라서 0, 10, 20의 모집단 표준편차는 √(200 ÷ 3), 약 8.164966입니다. 표본 표준편차처럼 N−1로 나누는 계산과는 값이 다릅니다. 다른 프로그램과 비교할 때 같은 종류의 표준편차인지부터 확인하세요.
중앙값이 극단값에 덜 흔들린다고 해서 표본의 편향까지 해결하지는 않습니다. 특정 시간대, 특정 고객 또는 답변한 사람만 모인 기록이라면 평균과 중앙값 모두 그 수집 범위 안에서 해석해야 합니다.
붙여넣기 전에 단위와 구분자를 확인합니다
- 초와 분, 원과 만원처럼 다른 단위는 먼저 하나로 맞춥니다.
- 이 도구의 쉼표는 숫자 구분자입니다. 1,200을 천이백으로 넣으려면
1200으로 입력하세요. - 1200과 2400은
1200 2400처럼 구분하면 평균 1800입니다. - ‘없음’이나 ‘NA’는 숫자 오류로 표시됩니다. 빈 구분자는 값으로 세지 않으므로 원래 행 개수와 결과 개수를 대조하세요.
- 0은 실제 관측값이 0일 때 넣습니다. 기록 누락을 임의의 0으로 바꾸면 평균이 내려갑니다.
숫자 하나보다 조건을 함께 적습니다
두 번째 예시는 ‘작업 시간 5건, 평균 40분, 중앙값 20분, 최소 16분·최대 124분, 실제 긴 작업을 포함’이라고 적으면 계산과 해석을 구분하기 쉽습니다. 실무 자료라면 여기에 수집 기간, 대상과 제외 규칙을 더하세요.
평균·중앙값의 정의와 극단값에 대한 차이를 참고했습니다. 위 목록, 팀별 건수와 비교 계산은 potatospark의 모의 예시이며 통계적 유의성이나 인과관계를 입증하지 않습니다.
이 글의 수치는 명시한 가정으로 구성한 예시입니다. 검증 기록은 자동 검사의 범위와 한계를, 계산·편집 원칙은 출처와 자동화 도구 사용 방식을 설명합니다. 오류는 문의로 알려 주세요.